Rapporten visar vad som hänt, men sällan varför
En rapport eller ett larm säger vad som har hänt, men sällan varför det hände. Det är där många företag fastnar: de får ett mejl från molnleverantören, en varning i en panel eller ett felmeddelande i en logg, men saknar tid eller specialkunskap för att tolka det och avgöra vad som ska göras. Resultatet blir att man antingen ignorerar varningen eller åtgärdar fel sak. Business IT Support tolkar felanalysrapporter och loggar från de stora plattformarna och översätter dem till konkreta åtgärder som en beslutsfattare kan förstå och prioritera. Vi arbetar med AWS, Azure, Oracle och Linux-servrar samt tillhörande webb- och databasmiljöer. Genom att läsa underlaget tillsammans med er, och jämföra det med hur systemen normalt beter sig, ser vi snabbare vad som är ett verkligt problem och vad som bara är brus. Det sparar tid, minskar risken för driftstopp och ger er ett underlag som går att agera på redan samma dag. Det är ofta här den största tidsvinsten finns, eftersom rätt tolkning direkt pekar ut vad som faktiskt behöver åtgärdas.
Var vi hämtar underlaget
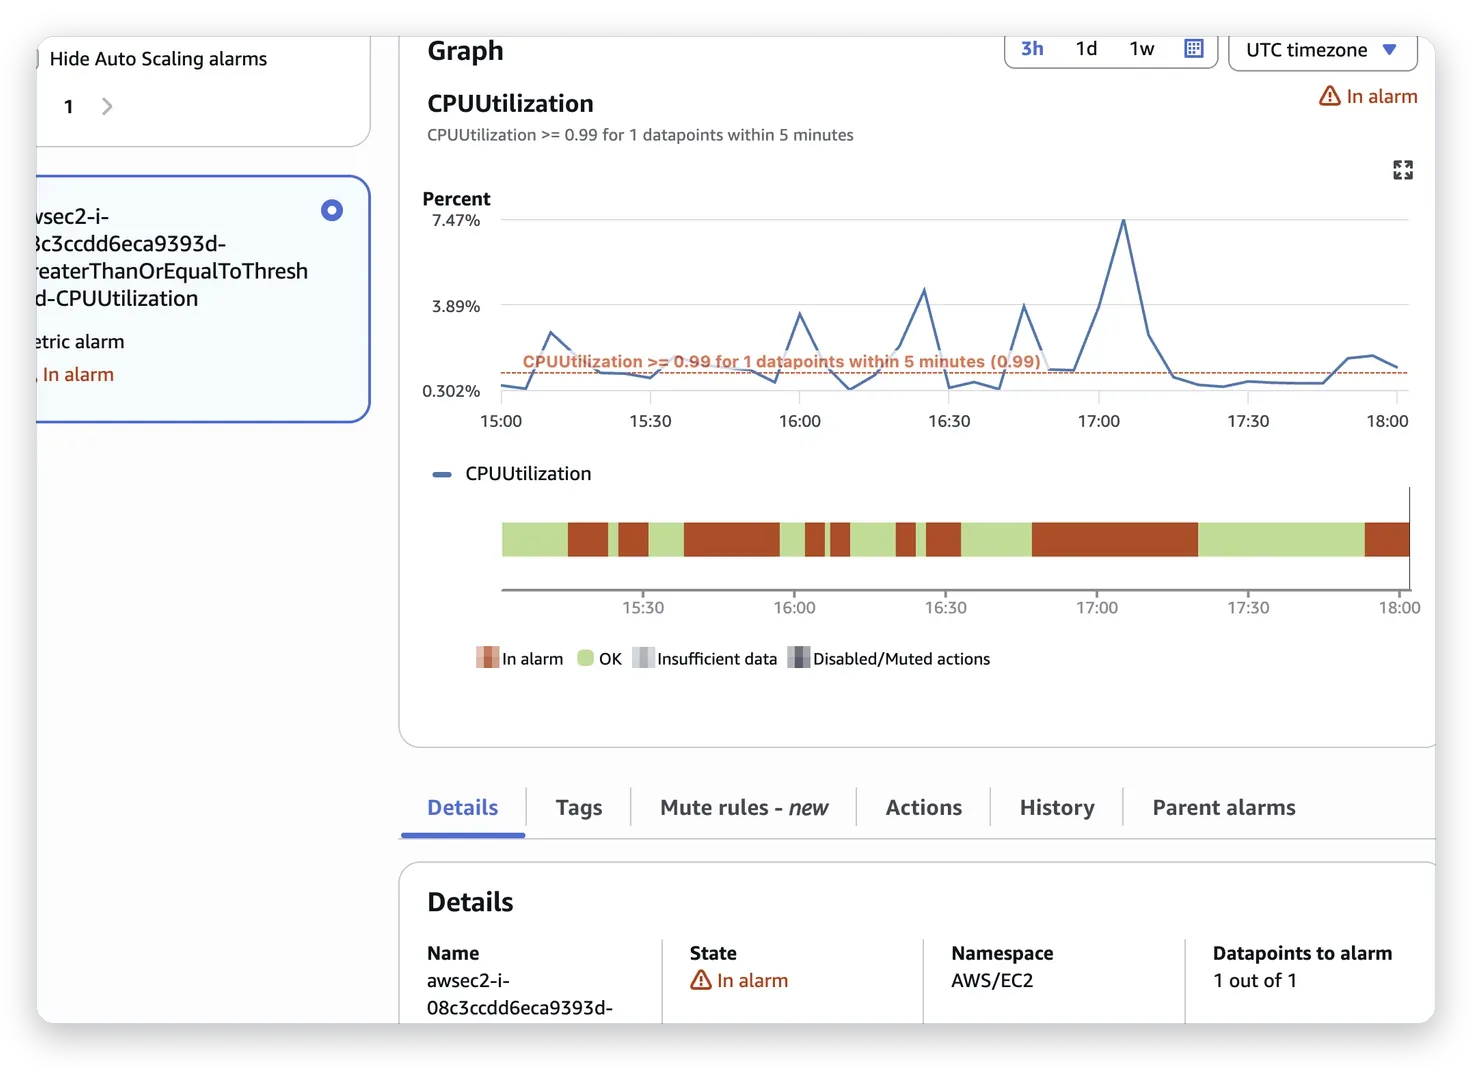
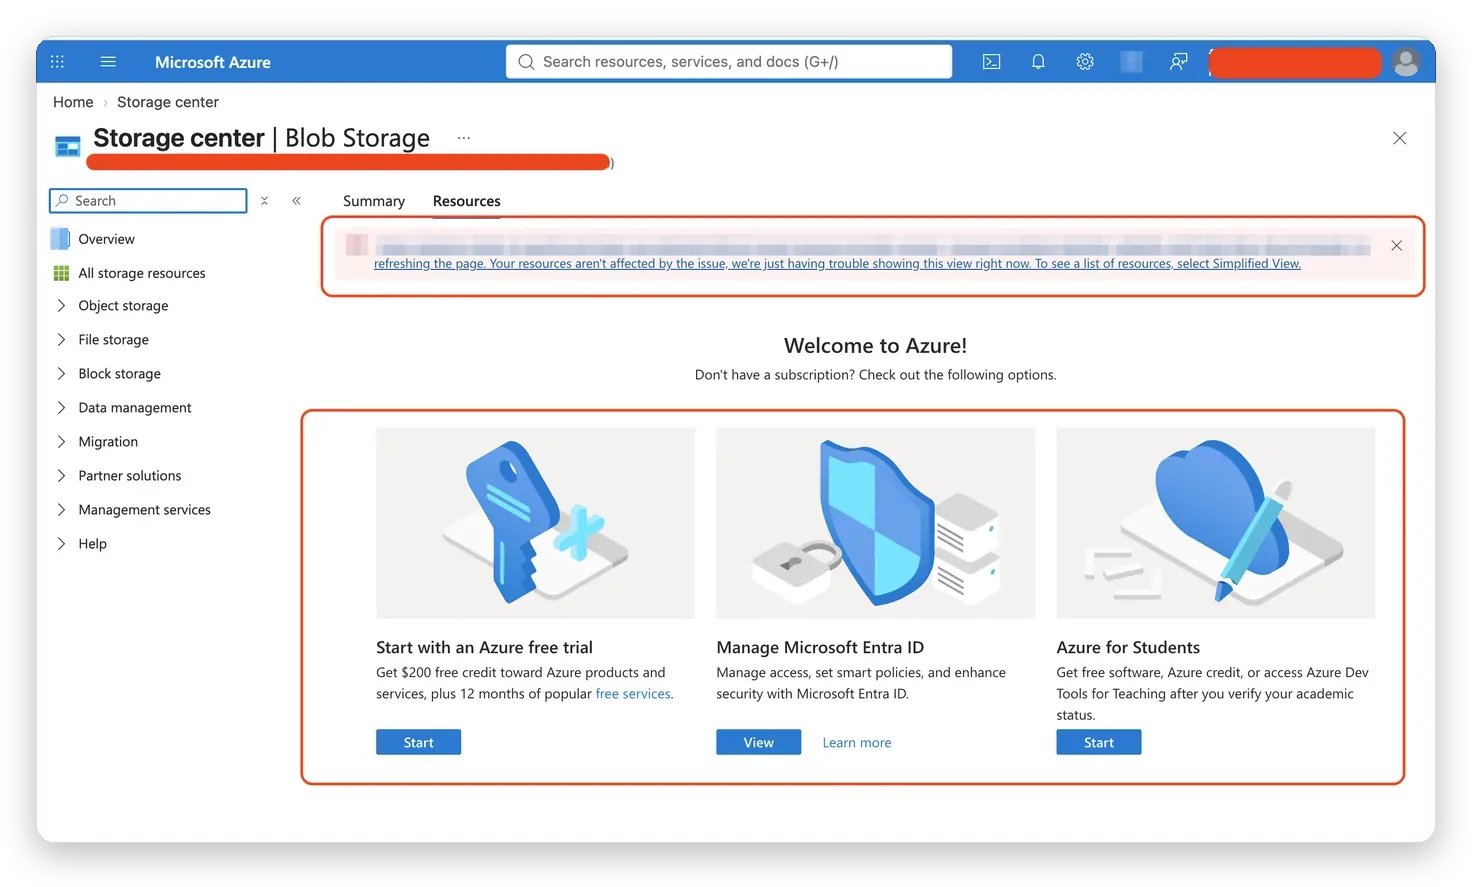
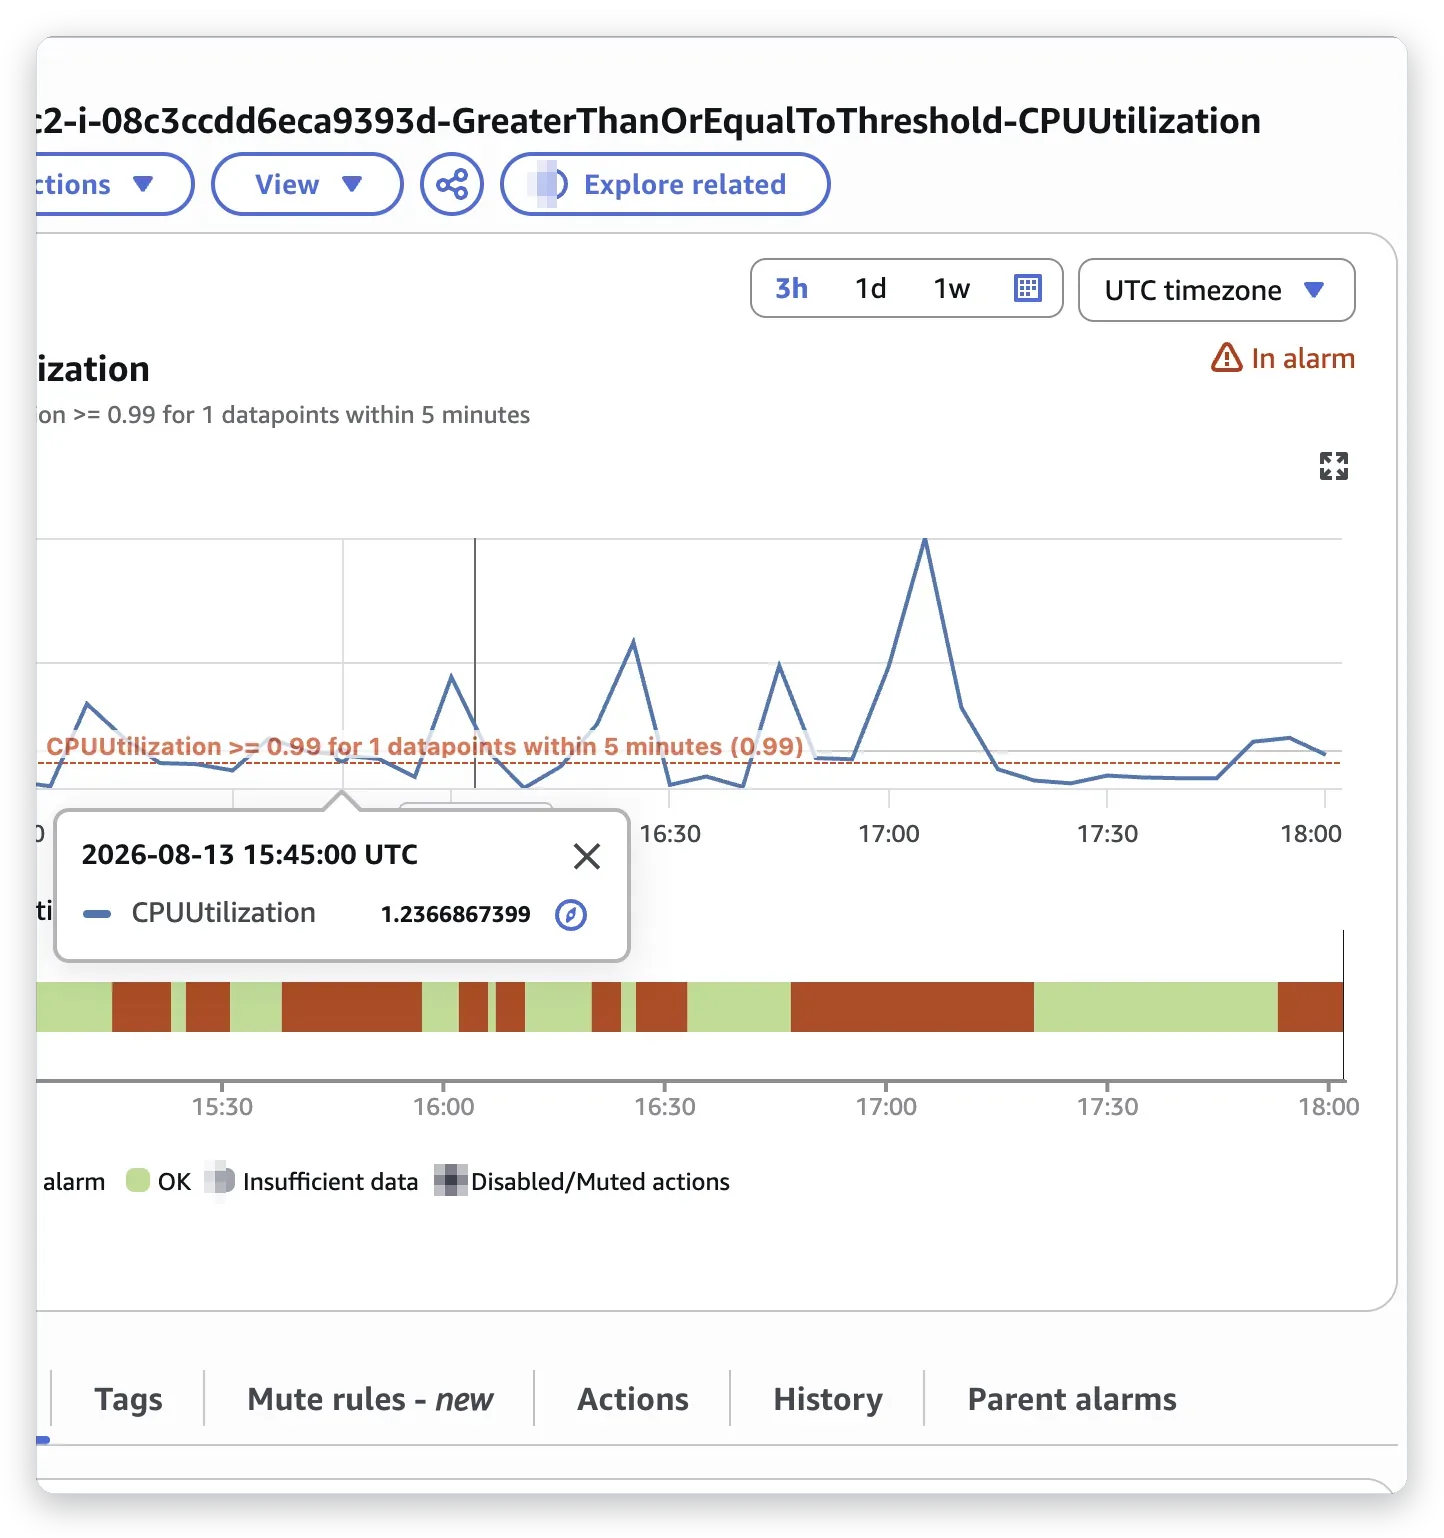
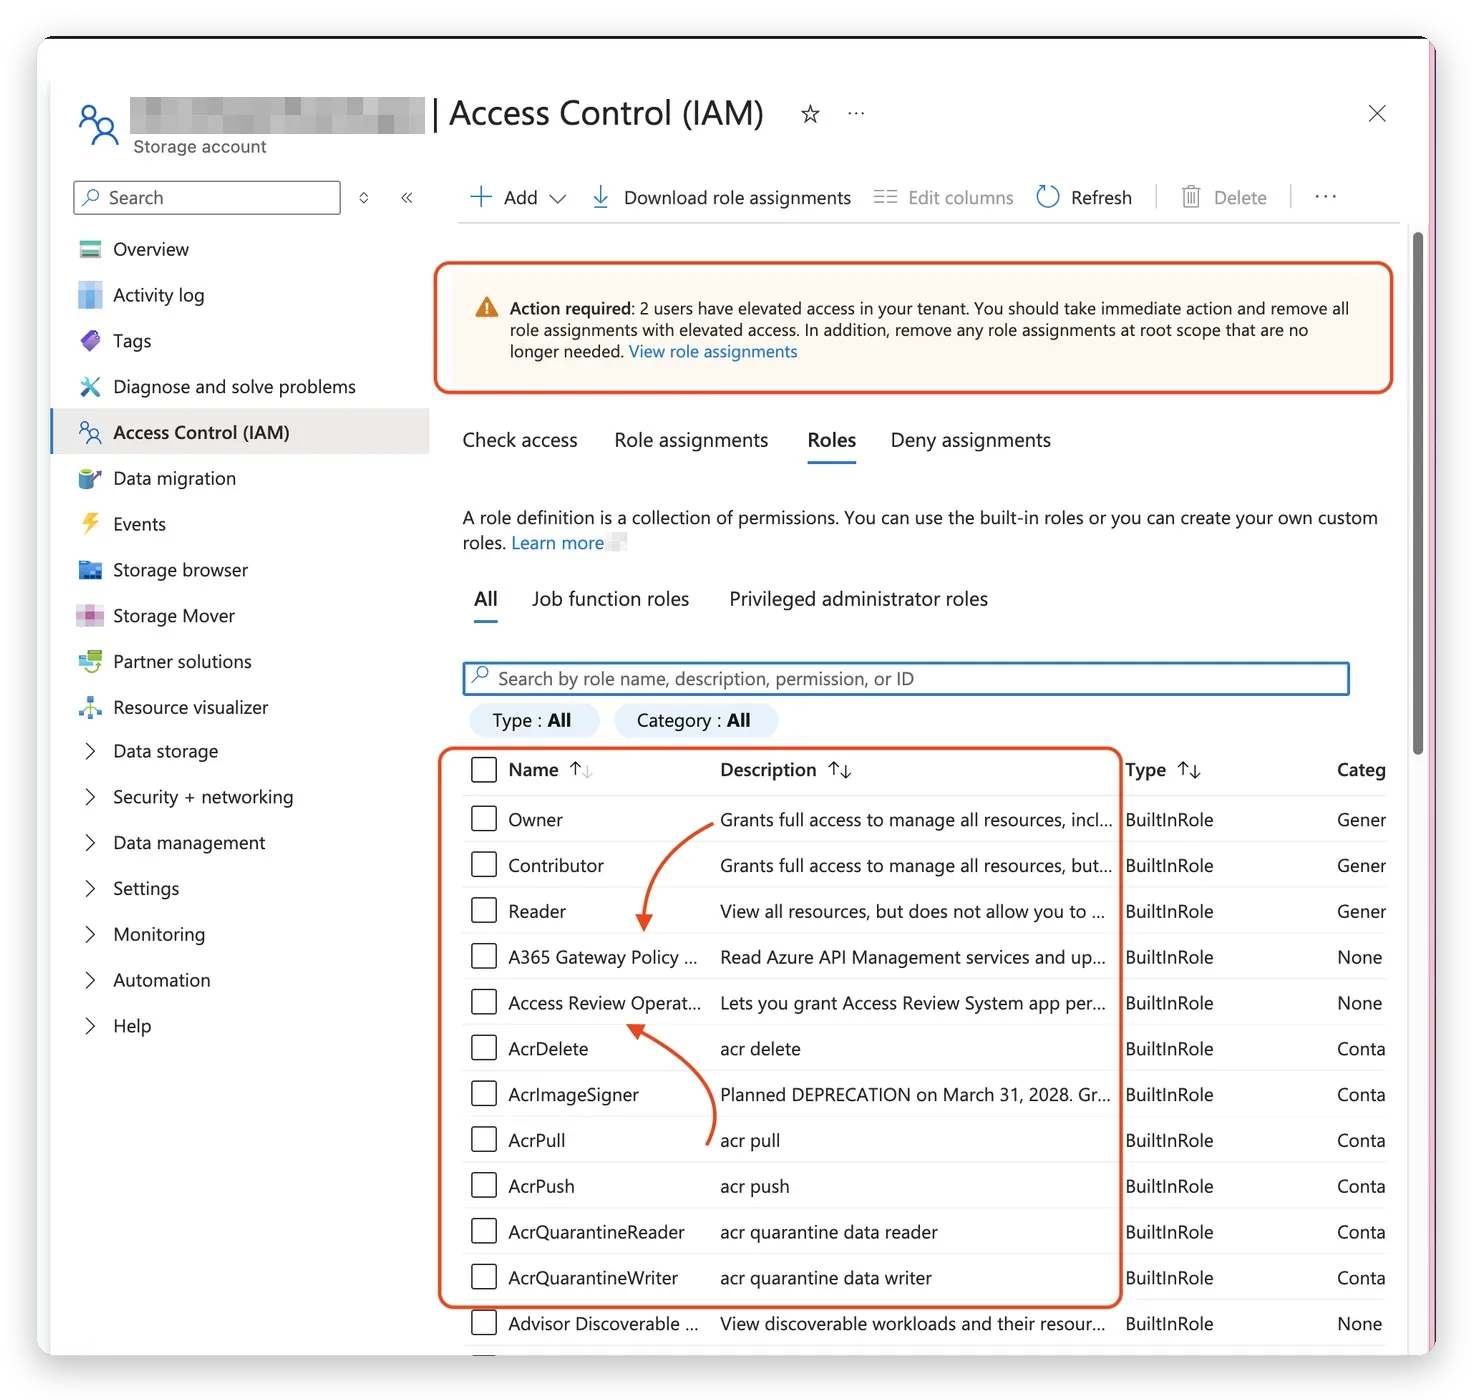
Underlaget finns på många ställen, och ingen enskild källa räcker ensam. På AWS använder vi CloudWatch, CloudTrail, AWS Health och Trusted Advisor. I Azure tittar vi i Activity Log, Service Health, Azure Advisor och Defender for Cloud. För Oracle-databaser läser vi alert-loggen, incidentpaket via ADRCI samt AWR- och ADDM-rapporter. På Linux-servrar använder vi journalctl och dmesg samt webbserverns och databasens loggar. Varje källa svarar på olika frågor: vissa visar prestanda, andra visar vem som gjorde vilken ändring och när, och några visar planerade eller pågående problem hos leverantören. Genom att korsreferera flera källor undviker vi att dra förhastade slutsatser från en enskild varning. Ett CPU-larm kan till exempel höra ihop med en ändring som gjordes en timme tidigare eller med trafik som inte hör hemma. Därför samlar vi underlaget på en tidslinje innan vi börjar dra slutsatser, och vi sparar utdragen så att analysen går att följa i efterhand. Genom att läsa flera källor samtidigt får vi en mer pålitlig bild än om vi lutar oss mot en enda varning eller panel.
Vår metod: tidslinje, avgränsning och grundorsak
Vi arbetar i fem steg. Först en tidslinje: när började felet, och vad ändrades just före? Sedan avgränsning: vilka system och användare påverkas, och vilka påverkas inte? Därefter grundorsak: vad förklarar symptomen på ett sätt som stämmer med alla observationer? Så åtgärd: rätta felet och verifiera att det verkligen är borta. Till sist förebyggande arbete: larm, uppdateringar och dokumentation så att samma fel inte återkommer. Skillnaden mellan symptom och orsak är avgörande. Ett felmeddelande som ORA-00600, en HTTP 500 eller ett CPU-larm är symptom. Grundorsaken kan vara en felaktig konfiguration, ett tillfälligt tjänsteproblem hos leverantören, för lite resurser eller ett intrång. Den som bara åtgärdar symptomet får ofta ett nytt larm några dagar senare. Metoden är densamma oavsett plattform, men detaljerna skiljer sig, och det är där erfarenhet av respektive miljö gör att felsökningen går snabbare och blir säkrare. Det kräver erfarenhet av varje miljö, men metoden gör att även svåra fel går att reda ut på ett strukturerat sätt.
Rapport med åtgärdsplan och prioritering
Resultatet av analysen blir en skriftlig rapport som beskriver vad som hände, varför det hände, vad som har gjorts och vad som bör göras härnäst. Vi prioriterar åtgärderna efter risk, så att ni vet vad som är akut, vad som kan vänta och vad som mest är en förbättring. Rapporten är skriven på vanlig svenska och går att använda både av teknisk personal och av ledningen, till exempel som underlag för beslut om budget eller leverantörskontakt. Om incidenten kan ha påverkat personuppgifter eller kunder hjälper den också vid bedömning av om något behöver anmälas eller kommuniceras. Dokumentationen gör nästa incident billigare, eftersom ni då vet hur systemet är uppbyggt och vad som gjorts tidigare. Utan dokumentation får man börja om från noll varje gång, ofta under tidspress och med den enda person som kan systemet frånvarande. Det är en risk många företag inte tänker på förrän det är försent. Rapporten blir därmed ett levande verktyg som hjälper er att fatta bättre beslut även långt efter att incidenten är löst.
Kontakta Datorkirurgen AB för felanalys
Så påverkas ert företag om felanalys uteblir: samma fel återkommer, eftersom bara symptomet åtgärdades; intrång upptäcks aldrig, eftersom loggarna inte läses; ni betalar för resurser som inte behövs eller drabbas av driftstopp för att de är för små; och avsaknad av dokumentation gör nästa incident dyrare. Det är ingen teknisk detalj som kan skjutas upp. Har ni en felrapport ni inte kan tolka? Business IT Support, en del av Datorkirurgen AB, hjälper företag i hela Sverige med felanalys, loggtolkning och åtgärder i AWS, Azure och Oracle. Skicka rapporten eller loggutdraget, så tolkar vi den och föreslår åtgärder. Kontakta oss så går vi igenom er miljö, rättar felen och ser till att lösningen fortsätter fungera. Vi kan även ta över den löpande supporten, så att ni slipper ta tag i det själva. Vi börjar gärna med en kort genomgång utan förpliktelser, så att ni vet vad som är rimligt att göra först.
Vanliga supportfrågor
Frågor om felanalys och loggar
- Hur tolkar man en felanalysrapport?
- Vad är skillnaden mellan symptom och grundorsak?
- Hur läser man CloudWatch-loggar?
- Vad är CloudTrail och vad används det till?
- Vad visar AWS Health Dashboard?
- Vad är Azure Activity Log?
- Vad visar Azure Service Health?
- Vad är Azure Advisor?
- Hur använder man journalctl för felsökning?
- Hur skapar man en tidslinje vid en incident?
Frågor om Oracle och databaser
- Vad betyder ORA-00600?
- Hur läser man Oracles alert-logg?
- Vad är ADRCI?
- Vad är en AWR-rapport?
- Vad är ADDM i Oracle?
- Hur hittar man långsamma SQL-satser?
- Hur felsöker man en databas som är långsam?
- Hur felsöker man en HTTP 500-felkod?
- Varför får jag ett CPU-larm utan trafikökning?
- Hur skiljer man intrång från vanliga fel?
Frågor om åtgärdsplan och support
- Hur prioriterar man åtgärder efter en incident?
- Vad ska en incidentrapport innehålla?
- Hur dokumenterar man en incident?
- Hur undviker man att samma fel upprepas?
- Vilka larm bör man ha i molnet?
- Kan ni läsa en rapport vi redan har?
- Vilka plattformar täcker ni?
- Hur snabbt kan ni svara?
- Kan ni ta över löpande support?
- Hur kontaktar jag er om felanalys?
[dk_natverk compact=”1″]